
Языковые модели по API с оплатой в рублях
Создайте ключ, пополните баланс и отправляйте запросы на один endpoint в формате Chat Completions. Модели разных разработчиков переключаются полем model, а стоимость каждого запроса видна в ответе и в истории.
Кабинет — на llm.liho.dev. Вход в кабинет нужен и для Liho Cowork.
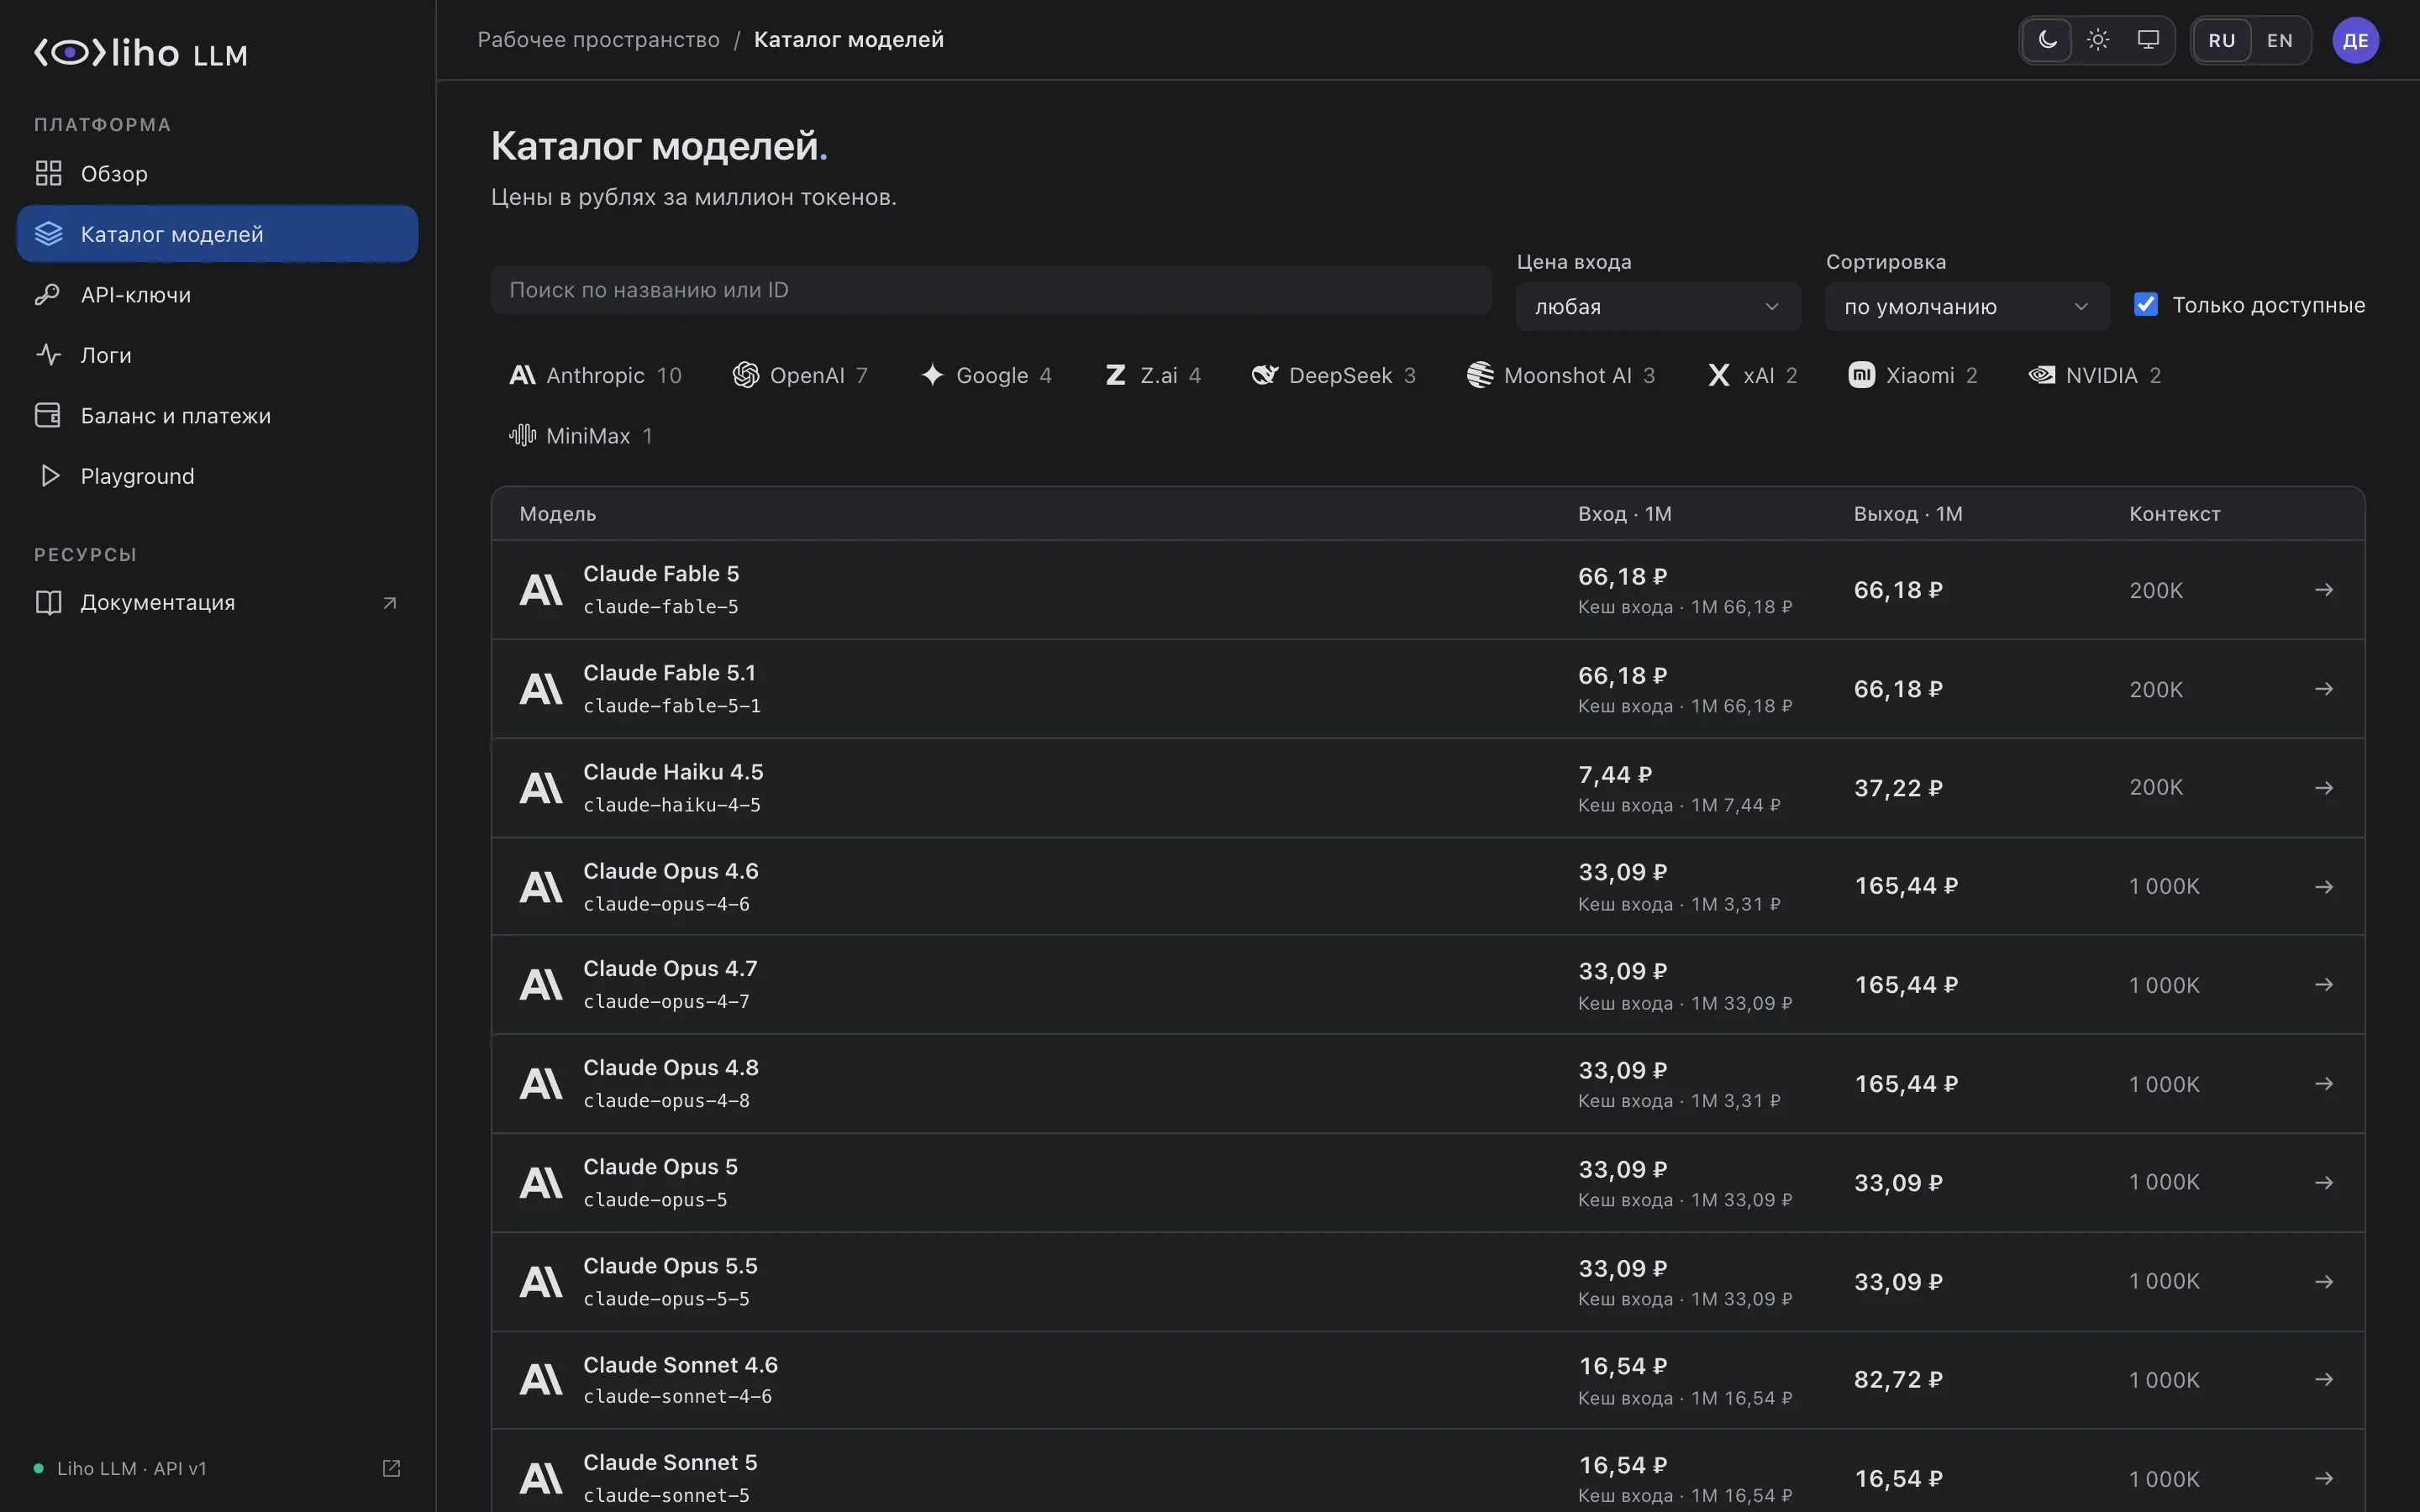
Три шага до первого ответа
Аккаунт и баланс
Зарегистрируйтесь на llm.liho.dev и пополните рублёвый баланс в разделе «Баланс и платежи».
Ключ
Создайте API-ключ. Секрет показывается один раз — сохраните его в переменной окружения.
Запрос
Отправьте POST на /v1/chat/completions. Для OpenAI SDK смените base_url и ключ.
curl https://llm.liho.dev/v1/chat/completions \
  -H "Authorization: Bearer $LIHO_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-sol",
    "max_tokens": 512,
    "messages": [
      {"role": "user", "content": "Объясни в двух предложениях, что такое API-шлюз."}
    ]
}'import os
from openai import OpenAI
client = OpenAI(
base_url="https://llm.liho.dev/v1",
api_key=os.environ["LIHO_API_KEY"],
timeout=900,
)
response = client.chat.completions.create(
model="gpt-6-sol",
max_tokens=512,
messages=[{"role": "user", "content": "Объясни в двух предложениях, что такое API-шлюз."}],
)
print(response.choices[0].message.content)import OpenAI from "openai";
const client = new OpenAI({
baseURL: "https://llm.liho.dev/v1",
apiKey: process.env.LIHO_API_KEY,
timeout: 900_000,
});
const response = await client.chat.completions.create({
model: "gpt-6-sol",
max_tokens: 512,
messages: [{ role: "user", content: "Объясни в двух предложениях, что такое API-шлюз." }],
});
console.log(response.choices[0].message.content);Поле max_tokens обязательно: по нему резервируется максимальная стоимость запроса.
Полное описание APIUpstream, настроенный под агентов
Запрос агента не похож на сообщение в чате. Модель с рассуждением может несколько минут молчать, а потом отдать десятки тысяч токенов, и у одного разработчика таких потоков идёт несколько сразу. Каждое звено на пути запроса — прокси, шлюз к провайдерам, учёт — в Liho LLM настроено под этот профиль, а не под короткий диалог.
- 45 с — простой потока в шлюзе
- 60 с — ожидание заголовков ответа
- ≈100 с — CDN закрывает тихое соединение
Один запрос живёт до 15 минут. После первого токена каждые 15 с без данных уходит keep-alive.
Чем отличается от обычной настройки
Время жизни запроса
ОбычноТайм-ауты прокси и шлюза по умолчанию — 45–100 секунд. Ответ после долгого рассуждения обрывается, хотя модель его генерирует.
В Liho LLM15 минут на один запрос, потоком или JSON. Все лимиты на пути — nginx, шлюз, учёт, остановка сервиса — выведены из этого числа и не срабатывают раньше.
Тишина в потоке
ОбычноСоединение без данных выглядит мёртвым: его закрывает CDN, балансировщик или read-timeout клиента.
В Liho LLMПосле первого токена сервер отправляет SSE-комментарий «: keep-alive» после каждых 15 секунд без данных — промежуточные прокси соединение не закрывают.
Обработка потока
ОбычноКаждый чанк разбирается как полный JSON или накапливается в буфере — поток идёт рывками.
В Liho LLMПотоковый сканер читает только нужные поля: 1,2 мкс и 4 аллокации на чанк вместо 5,2 мкс и 30 у декодера. Чанки не склеиваются: наибольшая пауза внутри потока, p99 — 78 мс при интервале upstream до 75 мс.
Много потоков сразу
ОбычноПоток занимает поток ОС или большой буфер, пул соединений упирается в лимит — очередь растёт до тайм-аутов.
В Liho LLMПоток стоит около 60–70 КиБ памяти и четырёх горутин. Выше заданной ёмкости сервис сразу отвечает 503, а не держит запрос в очереди до обрыва.
Учёт при сбоях
ОбычноКлиент получил поток, а списание не записано или записано по оценке.
В Liho LLMДо вызова модели резервируется худший случай, после ответа списывается фактический usage. Обрыв со стороны клиента не прерывает учёт: ответ дочитывается у провайдера ради точного расхода.
Замеры на нагрузочном стенде
- Длинные потоки с паузой рассуждения 50–110 с0 из 632323 из 323
- JSON-ответы после 50–110 с рассуждения31 из 16796 из 96
- Запросы, оставшиеся без расчёта7680
- Первое событие потока, p99, при интервале upstream до 75 мс350,7 мс80,4 мс
предыдущая сборка текущая
A/B на одном стенде: предыдущая сборка — со стандартными лимитами шлюза и прокси, текущая — с настройкой под агентов. Upstream детерминированный, поэтому это сравнительные числа, а не гарантии пропускной способности.
Почему агенту это важнее, чем чату
- Рассуждение без вывода
- Модели с рассуждением думают минуты до первого токена. Для прокси с тайм-аутом простоя такое соединение выглядит зависшим.
- Обрыв — потерянный шаг
- Агент повторяет вызов целиком и снова платит за входной контекст: у агентов это десятки тысяч токенов истории, файлов и результатов инструментов.
- Длинный вывод
- Правка нескольких файлов — это 10–30 тысяч выходных токенов, поток идёт минутами.
- Параллельность
- Агенты запускают подзадачи и инструменты одновременно: у одного разработчика открыто несколько долгих потоков.
Всё про расходы — в одном месте
Ключи и лимиты
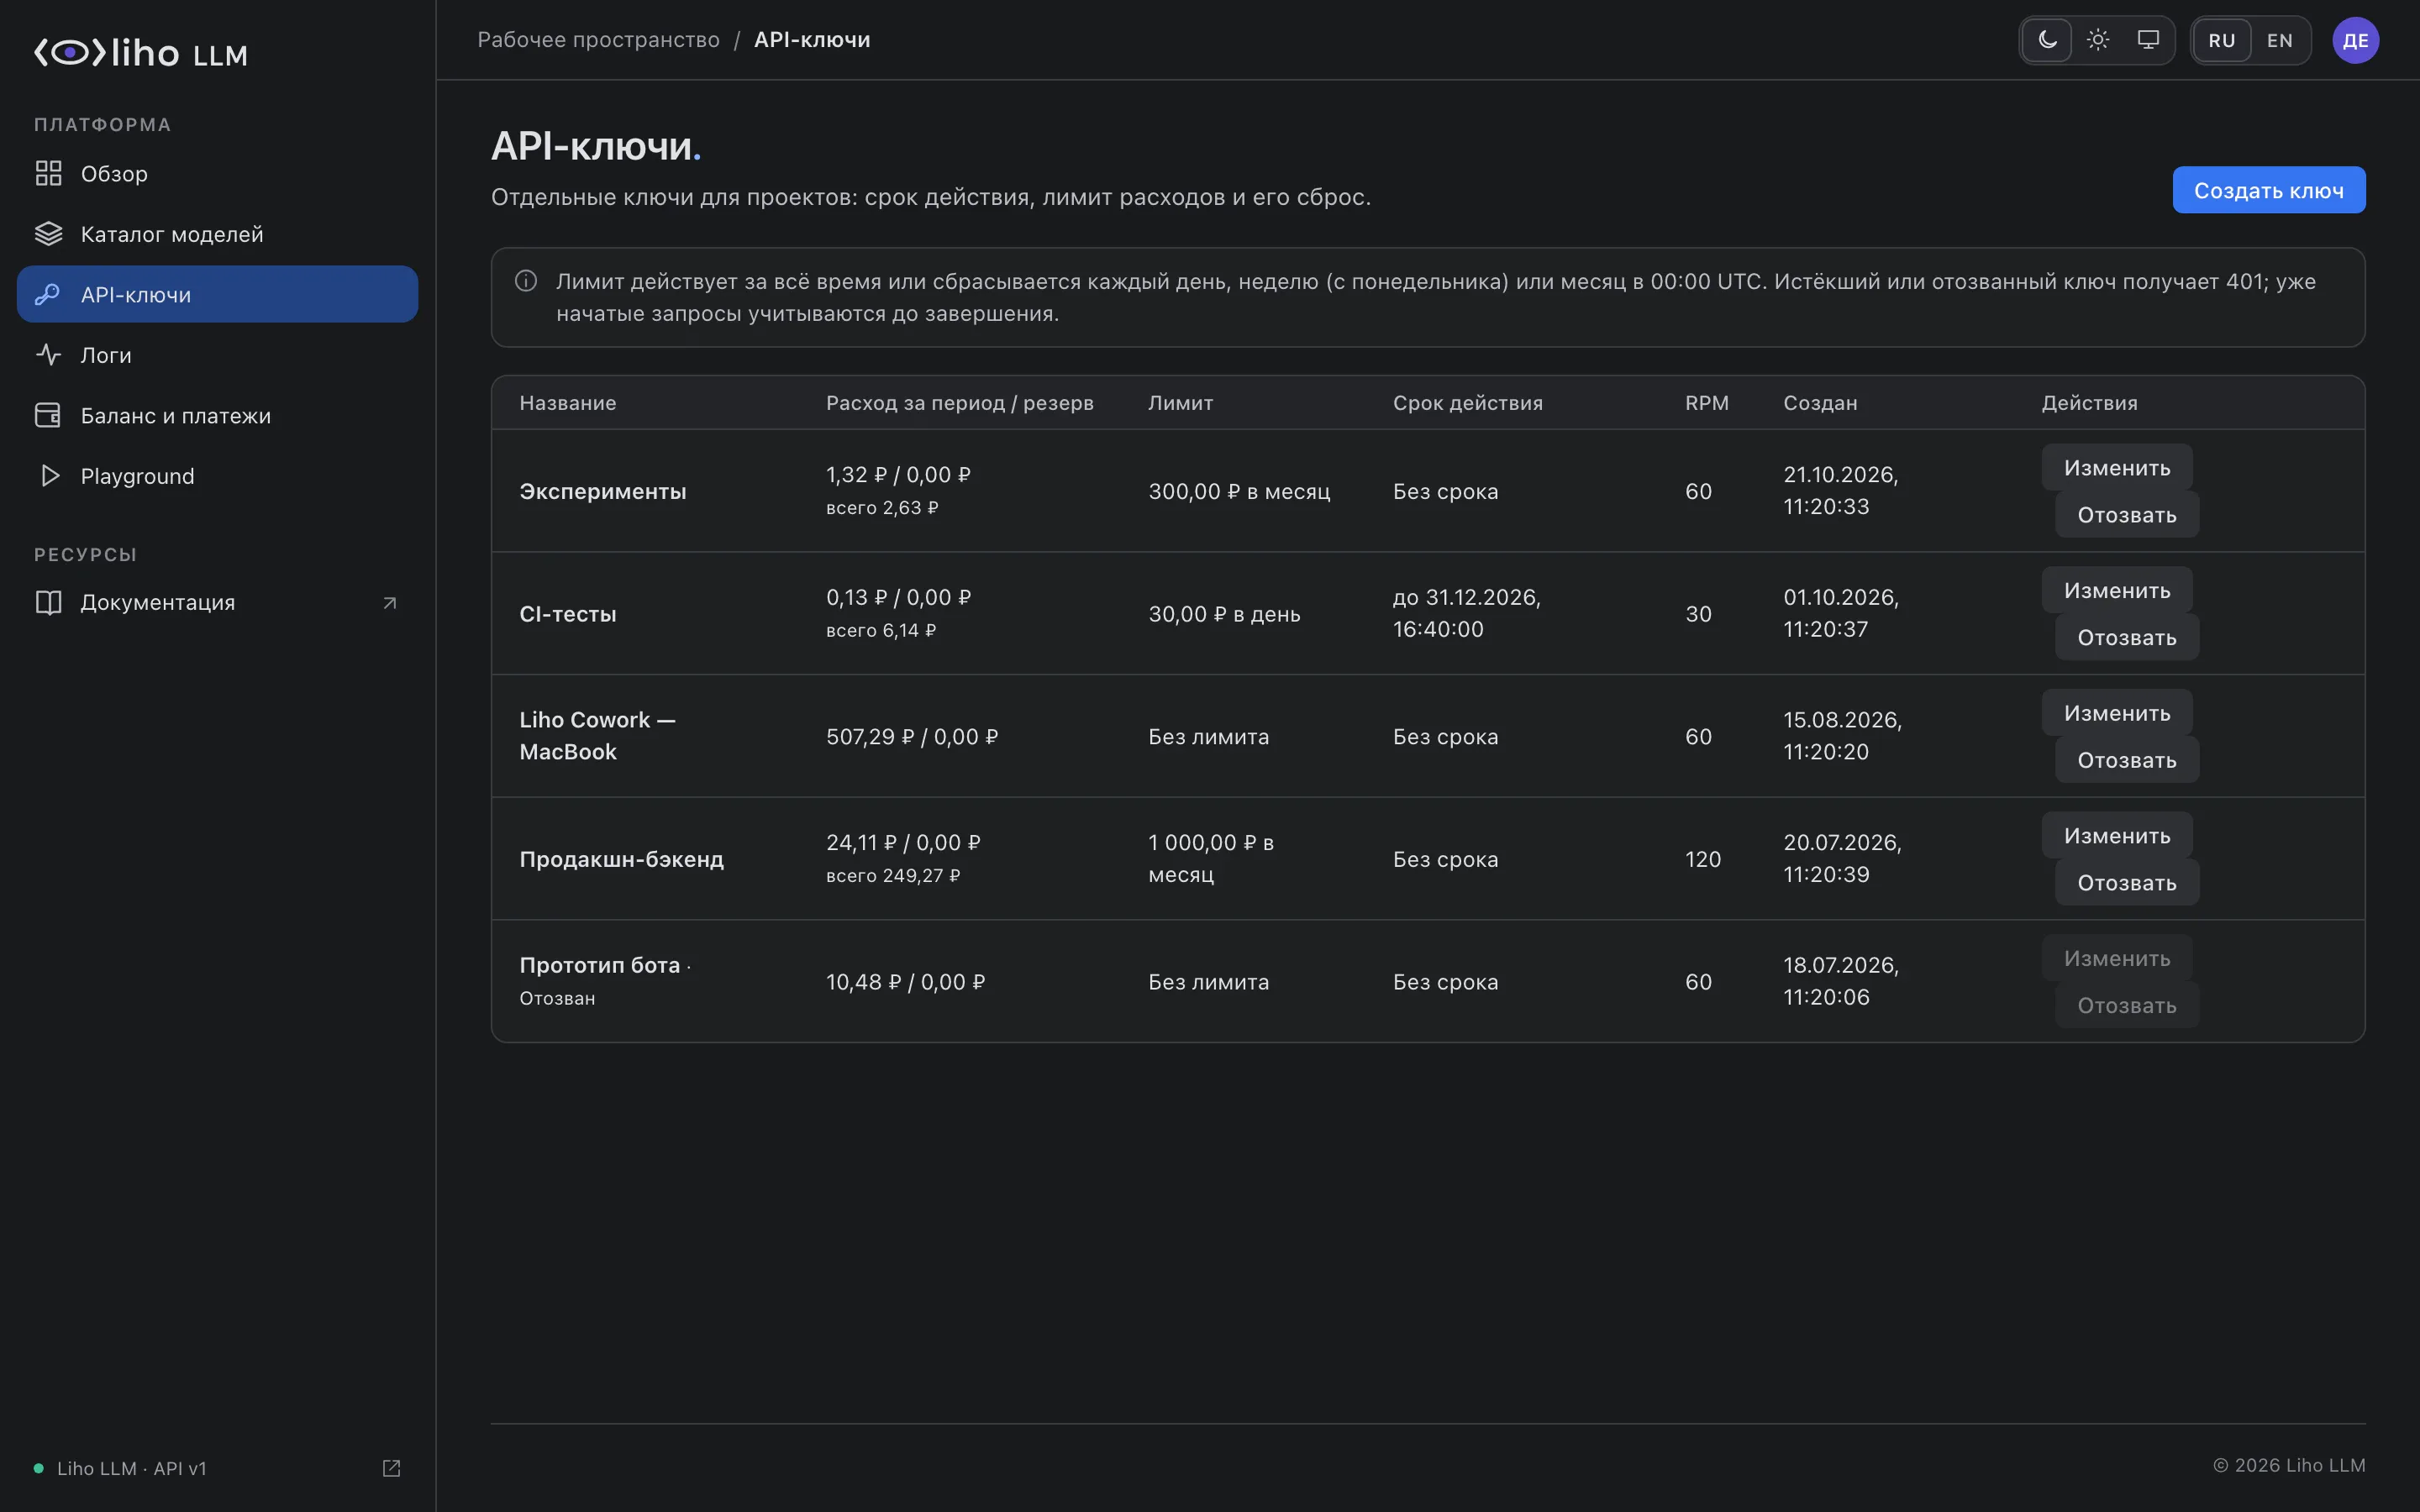
Отдельный ключ для каждого приложения или окружения. У ключа можно задать лимит расходов — на всё время или со сбросом каждый день, неделю или месяц, срок действия и лимит запросов в минуту. Отозванный ключ перестаёт работать, а его история сохраняется.
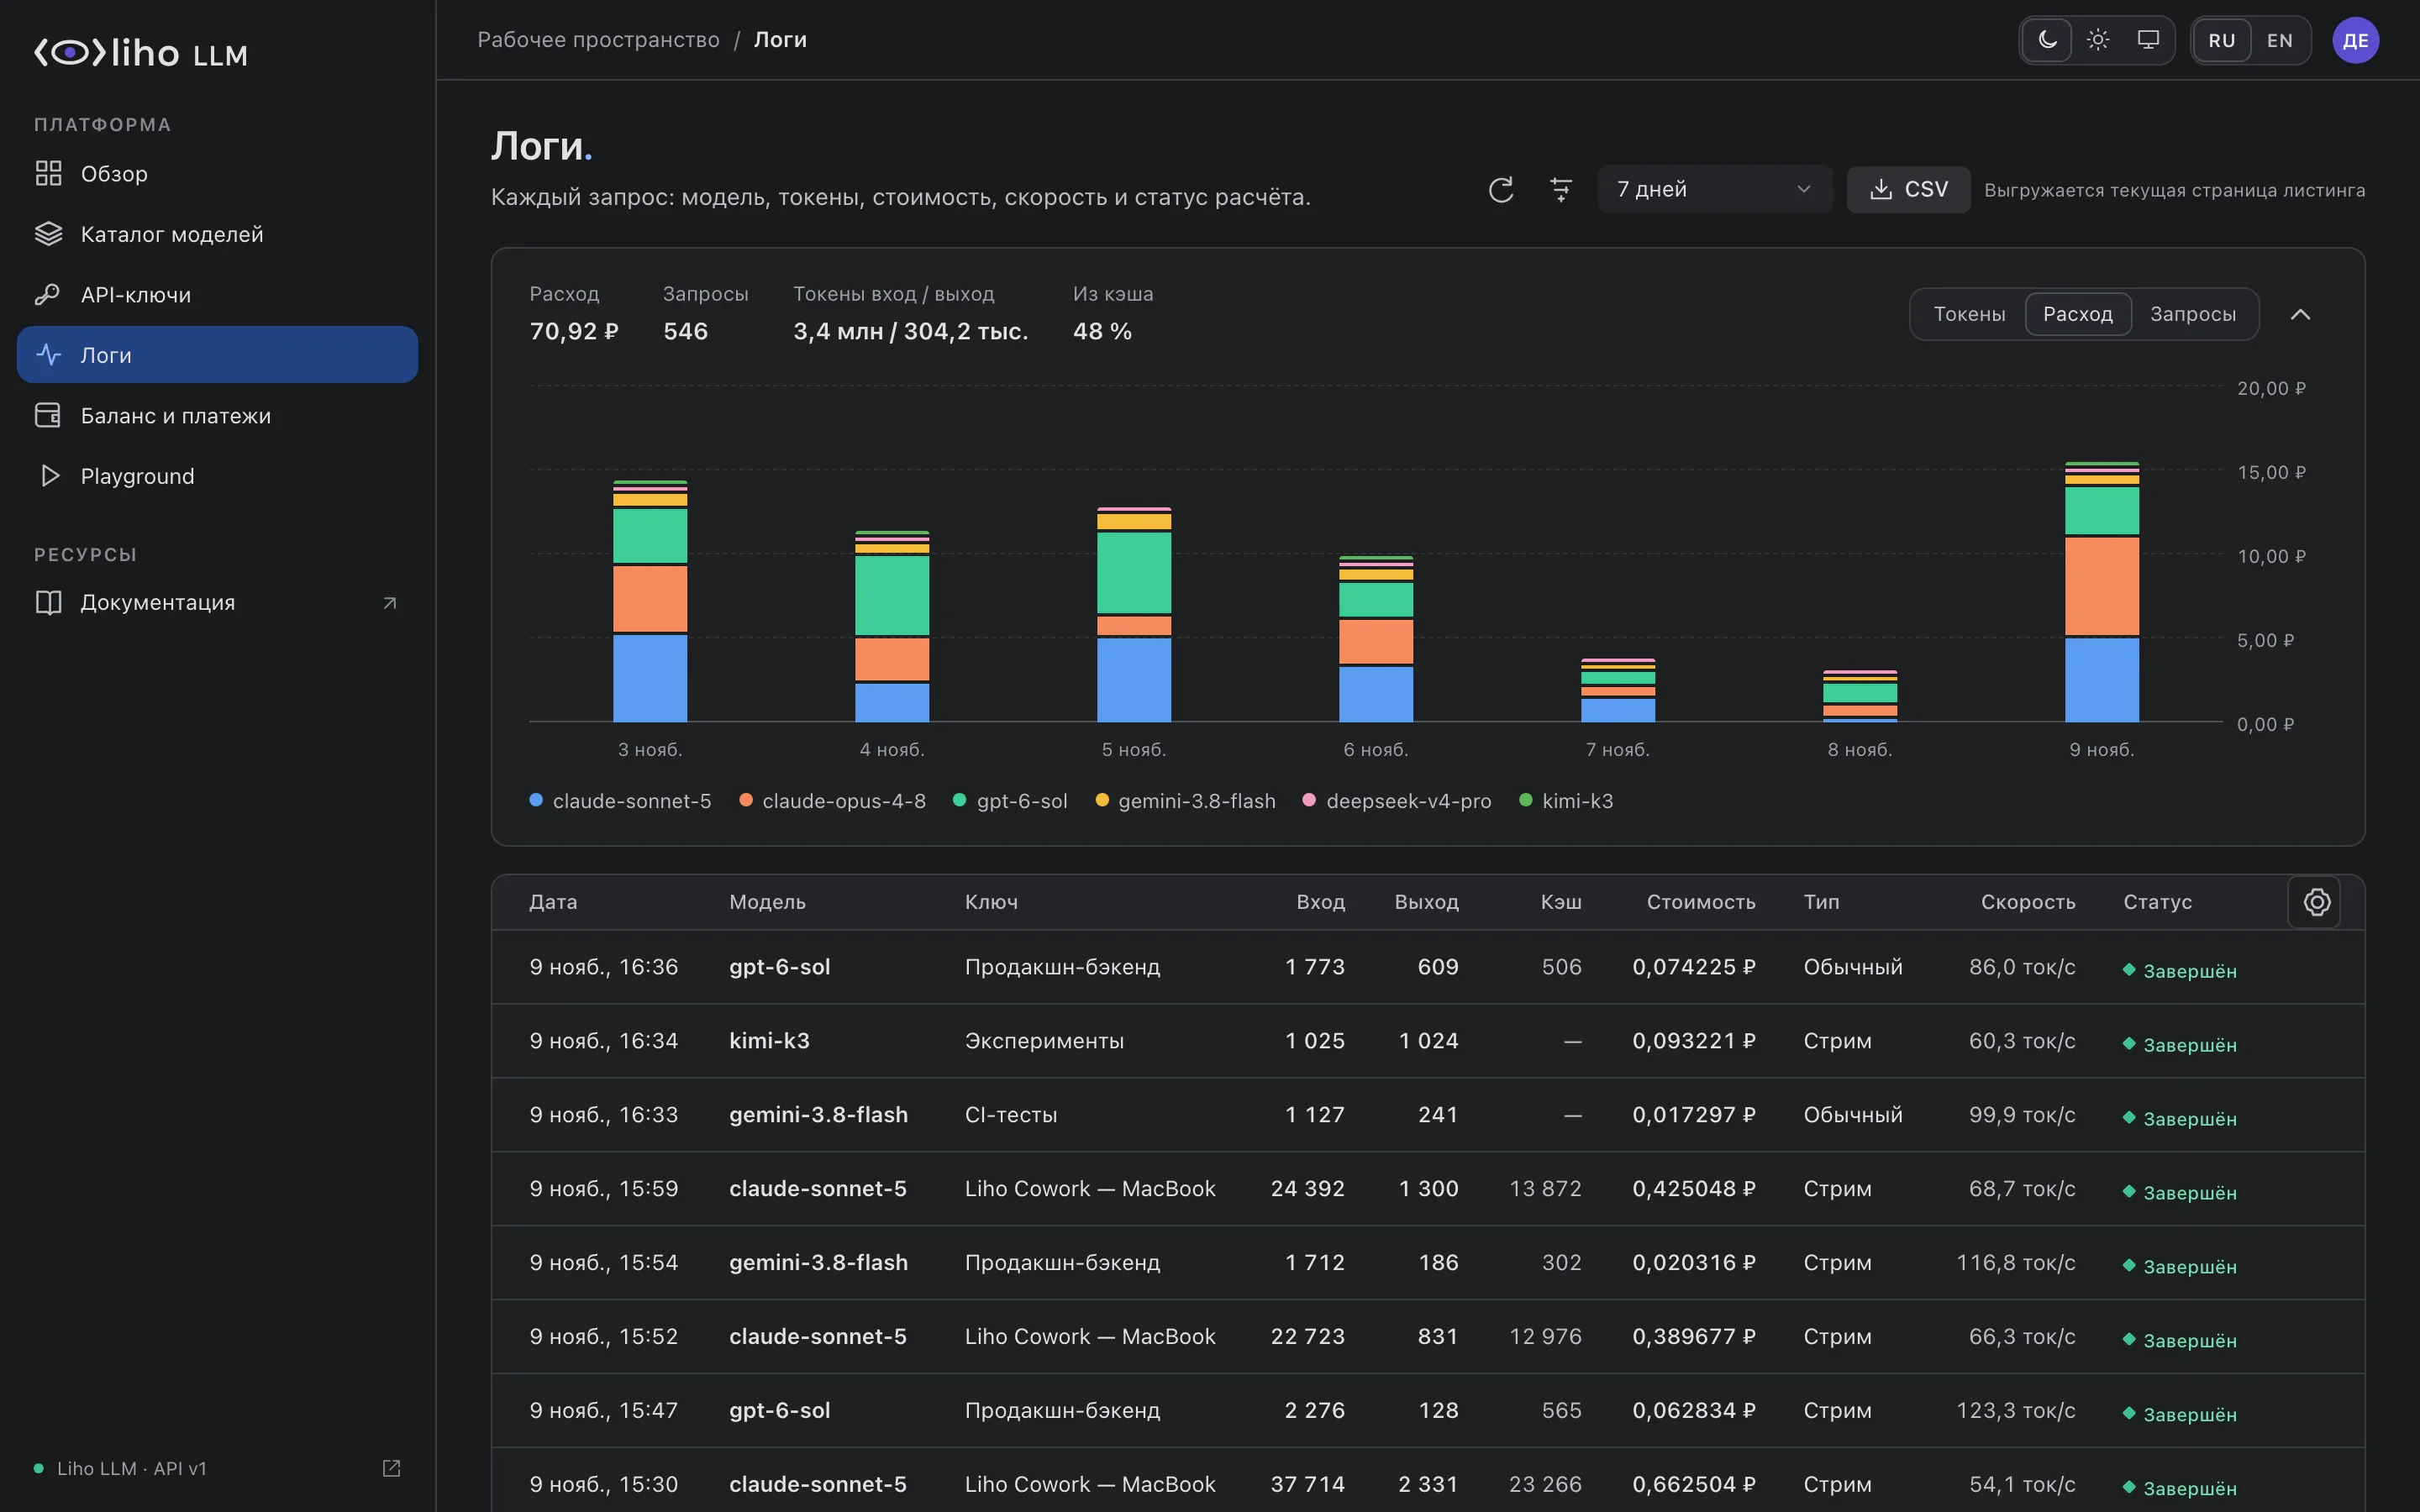
История запросов
Каждый запрос: модель, ключ, входные и выходные токены, кэш, стоимость, скорость и статус. Фильтры по дате, модели и ключу, графики расходов по дням и выгрузка в CSV.
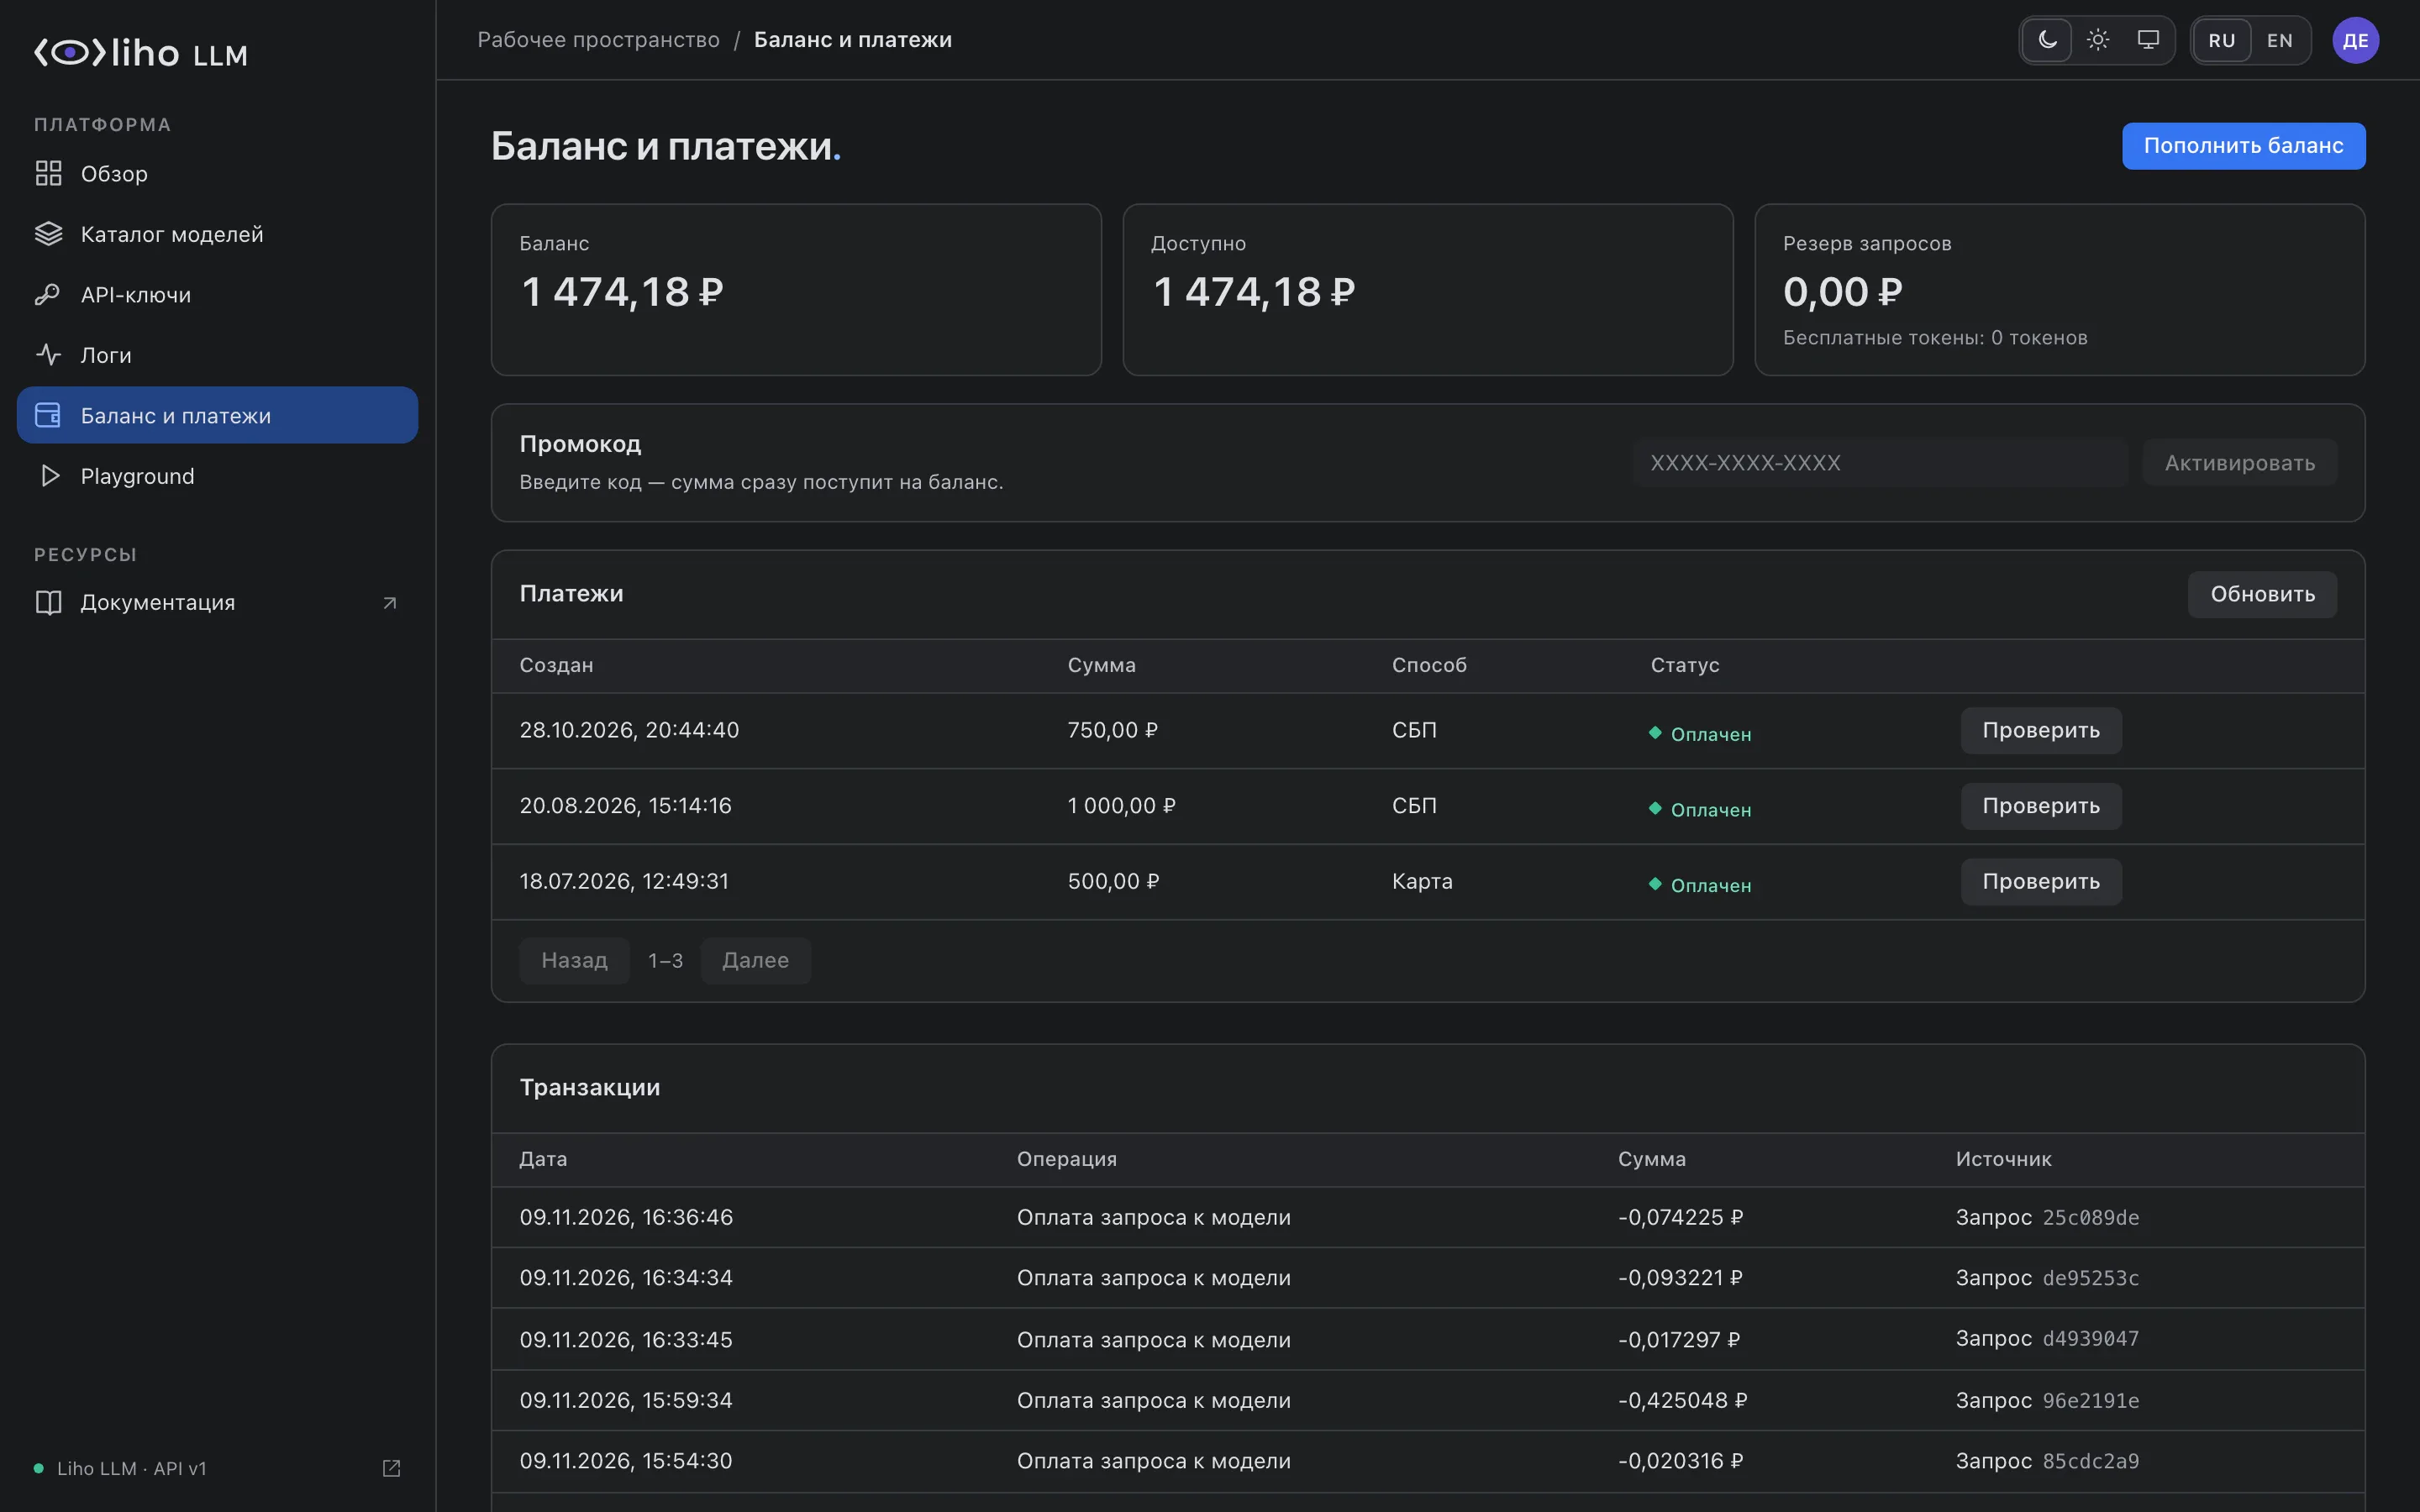
Баланс
Кабинет показывает баланс, резерв по запросам, которые ещё выполняются, и доступную сумму. В финансовой истории — пополнения и списания по каждому запросу.
Каталог и Playground
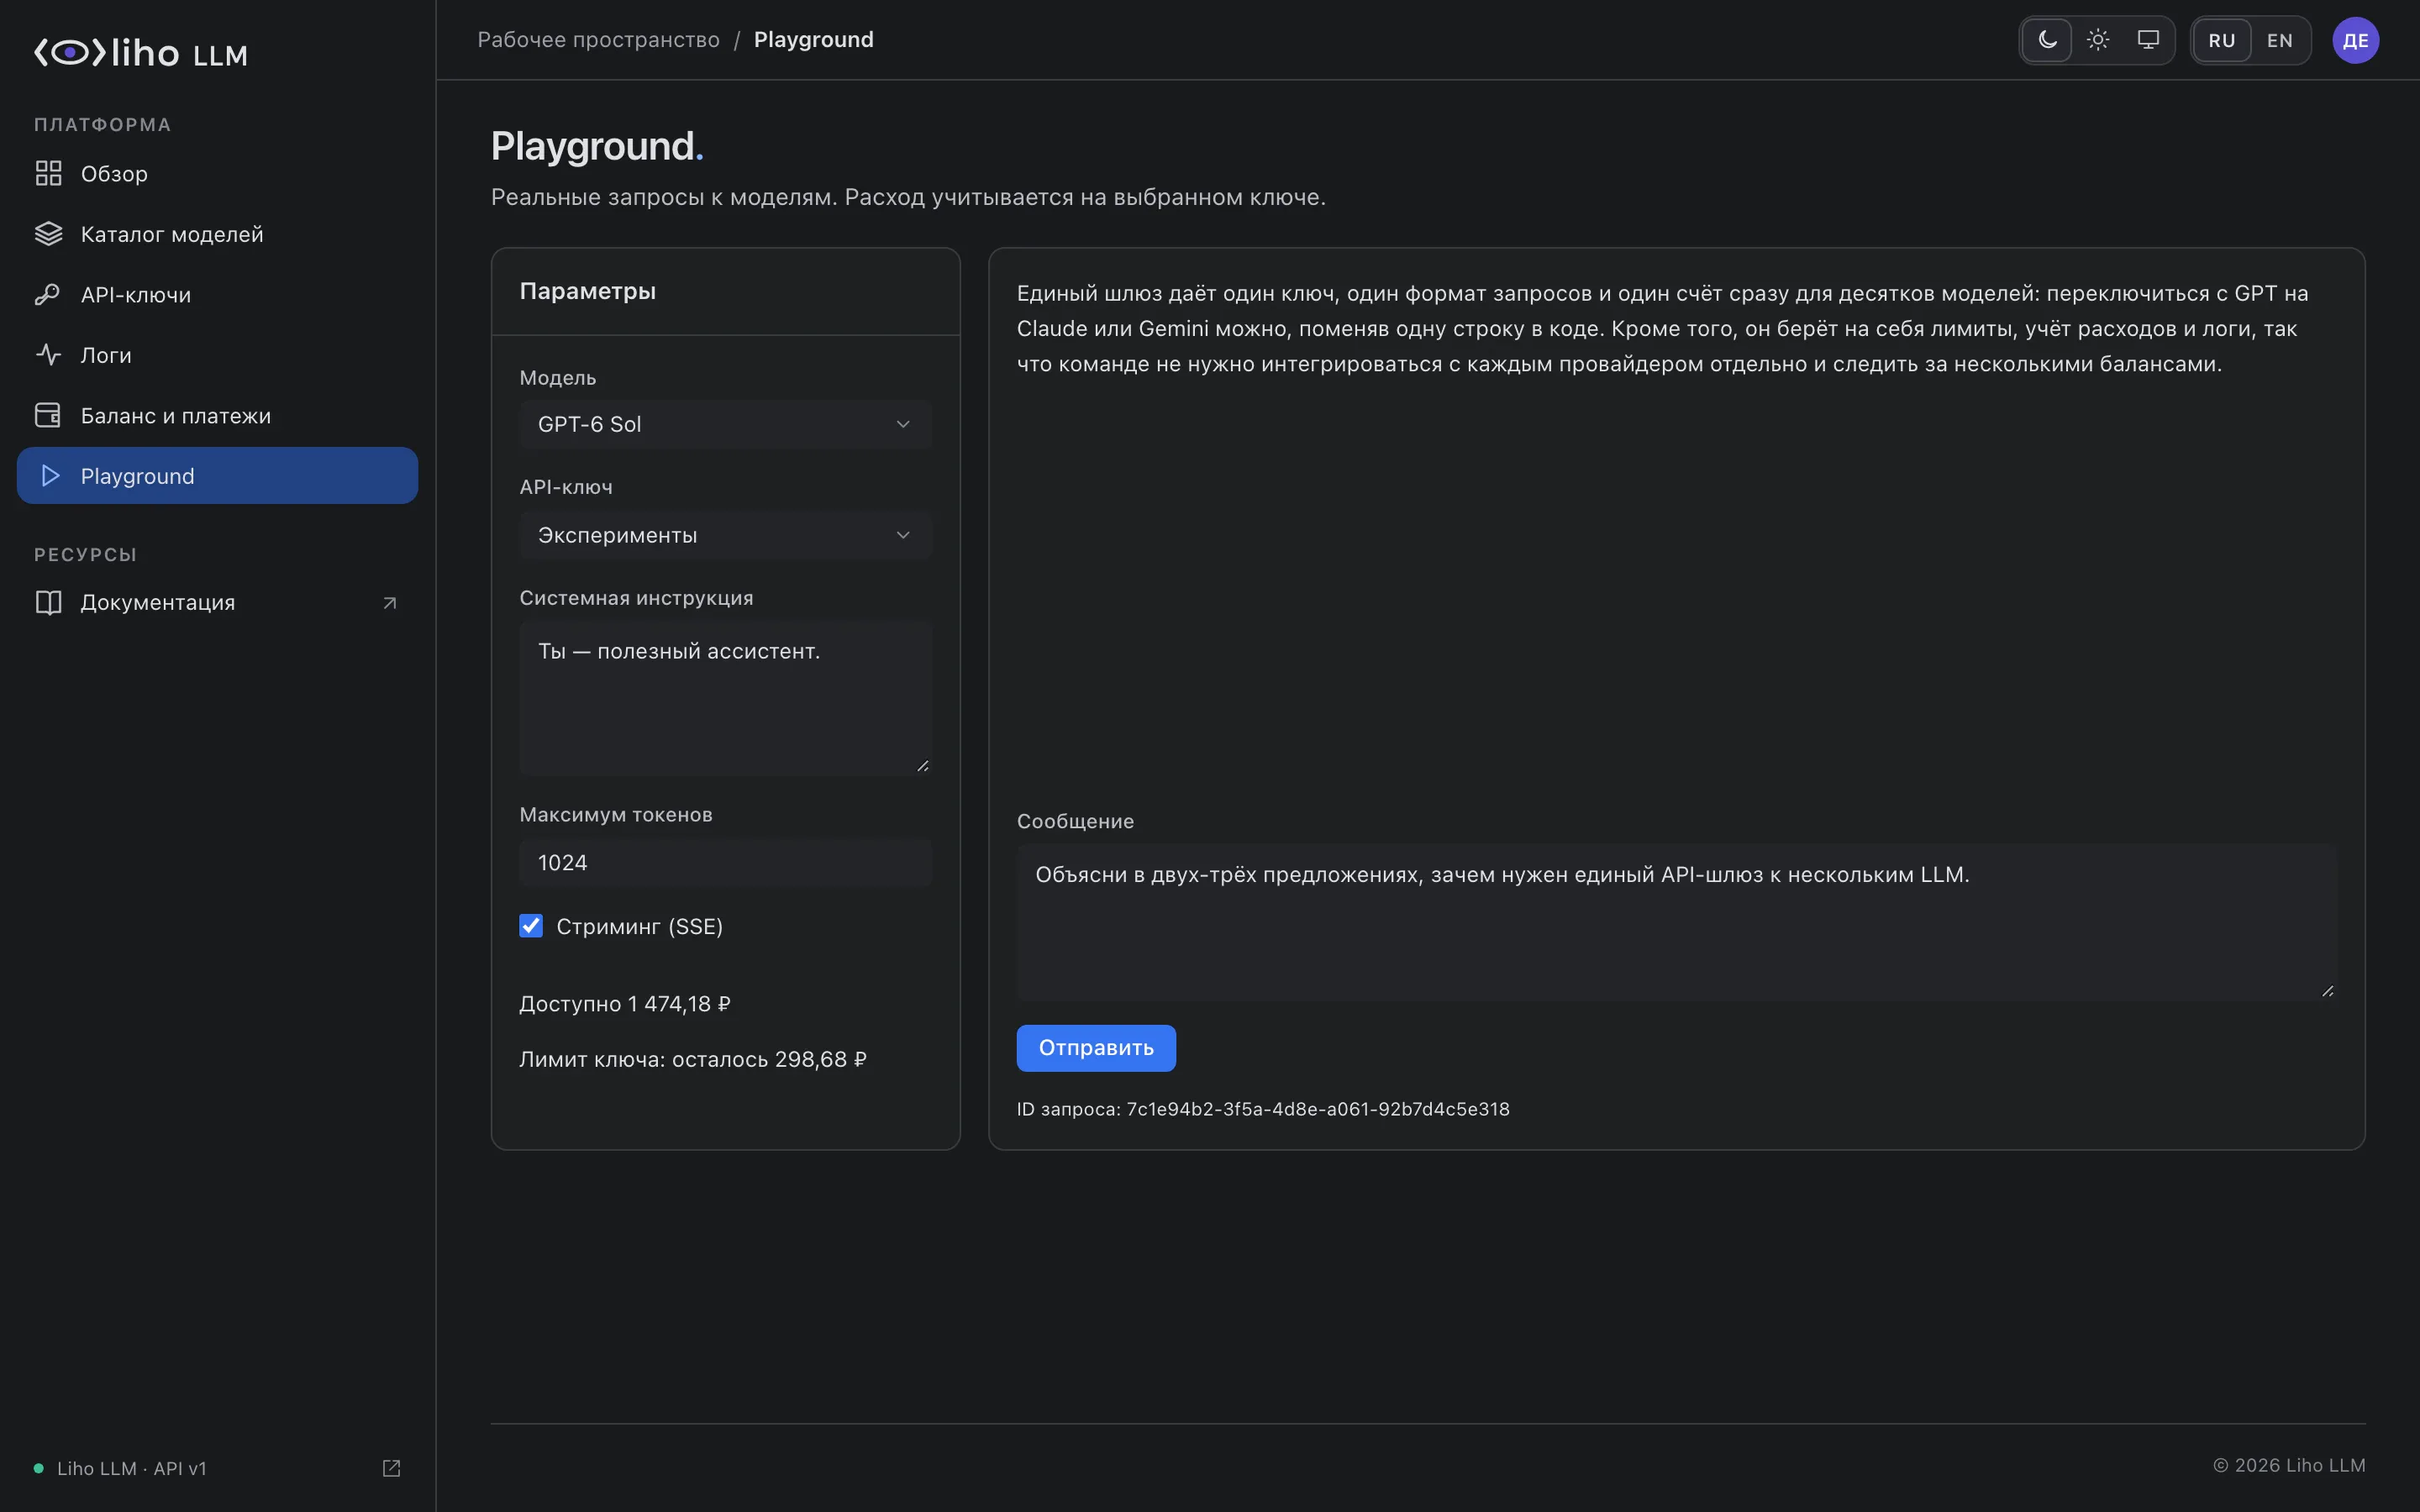
В каталоге — модели с ценами за 1 млн токенов и размером контекста. Из карточки модели можно перейти в Playground и отправить настоящий запрос: выбрать ключ, задать системную инструкцию и лимит токенов, включить потоковый ответ. Запрос оплачивается с выбранного ключа.
Платите за фактический расход
- Цены указаны в каталоге в рублях за 1 млн входных и выходных токенов и уже включают стоимость сервиса.
- Перед запросом резервируется максимальная стоимость — по длине запроса и max_tokens. После ответа списывается фактическая, остаток резерва возвращается на баланс.
- Стоимость запроса приходит в ответе API в поле usage.cost и отображается в истории.
- Токены рассуждения оплачиваются как выходные.
Что поддерживается сейчас
- Полная совместимость с OpenRouter: тот же формат запросов, ответов и ошибок и тот же API аккаунта — /v1/key, /v1/credits, /v1/generation, /v1/keys.
- POST /v1/chat/completions — обычные и потоковые ответы (SSE).
- Вызов инструментов (tools) — у всех моделей каталога.
- Уровень рассуждения (reasoning_effort) — у большинства моделей; список параметров есть в карточке модели.
- GET /v1/models — каталог для вашего ключа.
- Учёт ключа, баланса и отдельного запроса через /v1/key, /v1/credits и /v1/generation.
- Управляющие ключи для создания и отзыва ключей через API.
В следующем релизе
Режим Auto
Liho LLM сам подберёт модель под задачу — за 10 мс.
Responses API, embeddings, изображения и аудио
Новые типы запросов появятся в том же API и с той же оплатой с рублёвого баланса.
Не поддерживается
- Протокол Anthropic Messages (/v1/messages).
Приложения Liho и ваши инструменты
Liho Cowork
Получает модели только через Liho LLM: вход, каталог и оплата — с этого аккаунта.
Liho IDE
Вход в Liho LLM из IDE создаёт подключение к моделям для агента. Можно использовать вместе с другими провайдерами.
Ваш код
OpenAI SDK для Python и TypeScript — для базовых текстовых запросов достаточно сменить base_url и ключ.
В документации кабинета есть инструкции по настройке Codex CLI, Cursor, Cline, Roo Code, Aider и других инструментов. Совместимость каждого инструмента проверяйте на своей задаче: поддерживается только описанная часть API.
Вопросы о Liho LLM
Нет, только в описанной части: Chat Completions (включая потоковые ответы и инструменты) и список моделей. Responses API, embeddings, изображения и аудио не поддерживаются. Неизвестные поля запроса отбрасываются и перечисляются в заголовке ответа X-Liho-Ignored-Fields.
Да, полностью: тот же формат запросов и ответов, ошибок и заголовков HTTP-Referer и X-Title, тот же API аккаунта — /v1/key, /v1/credits, /v1/generation, /v1/keys. Чтобы перейти, смените base_url на https://llm.liho.dev/v1 и ключ.
Входные токены умножаются на цену входа, выходные — на цену выхода; для моделей с ценой кэшированного входа кэшированные токены считаются по ней. Цены — в рублях за 1 млн токенов, по каталогу на момент запроса.
Это резерв: перед запросом блокируется максимальная стоимость по max_tokens. После ответа списывается фактическая сумма, а остаток резерва сразу возвращается. В кабинете резерв показывается отдельно от баланса.
По политике конфиденциальности сервис не хранит тексты запросов и ответов — только метаданные: модель, токены, стоимость, время. Провайдеры моделей обрабатывают запросы по своим правилам.
Да. Создайте для приложения отдельный ключ и задайте лимит расходов и лимит запросов в минуту. При исчерпании лимита ключ получает ответ 402.
Нет. Сервис работает по предоплате: запросы оплачиваются с баланса.
Получите ключ и отправьте первый запрос
Регистрация — на llm.liho.dev. Пошаговый пример с curl, Python и потоковым ответом — в руководстве.